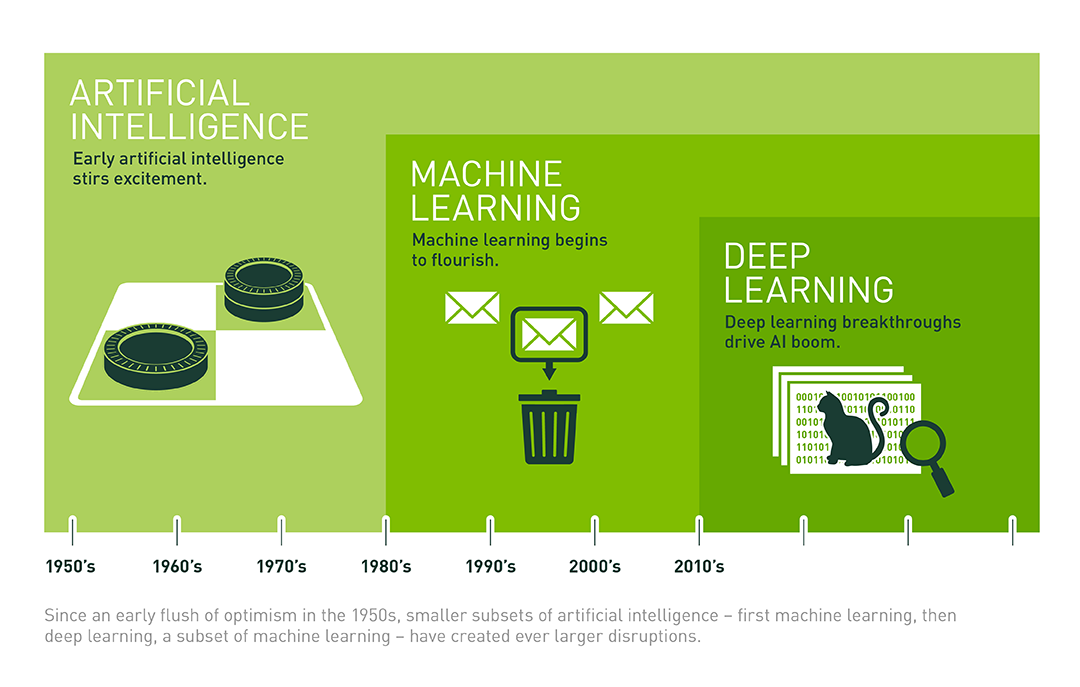
위 그림처럼 딥러닝은 머신러닝의 한 종류이며, 머신러닝은 인공지능의 한 종류입니다.
머신러닝은 간단히 ‘데이터를 이용한 모델링 기법’이라고 표현할 수 있습니다. 다시 말하면, 데이터들 중에서 ‘모델’을 뽑아내는 기법입니다. 모델은 머신러닝을 통해 얻을 수 있는 최종 결과물을 의미합니다. 예를 들어, 스팸을 분리해내는 시스템을 만들었다면 해당 시스템이 ‘모델’에 해당합니다.
모델은 ‘가설(Hypothesis)’이라고도 부릅니다.
Overfitting은 머신러닝에 자주 등장하는 용어입니다. 학습 데이터에 너무 최적화를 하다보니, 실제 데이터와 차이가 많이 발생하는 모델을 만들게 되는 현상을 의미합니다. 학습 데이터에도 Noise 등이 섞인 데이터들이 섞여 있을 수 있기 때문에 Overfitting을 방지하는 기법들을 적용해야 더 좋은 결과물이 나올 수 있습니다.
반대되는 경우로 Underfitting이 있습니다.
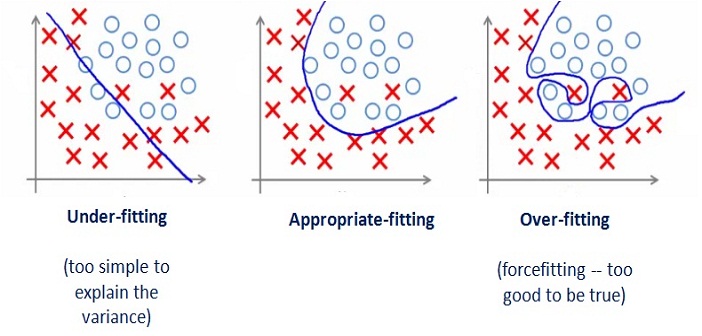
위 그림과 같이 Underfitting이 되면 너무 느슨한 모델이 만들어지게 되고, Overfitting이 발생하면 너무 과한 모델이 만들어지게 됩니다.
머신러닝은 학습 데이터가 많을수록 더 정교한 모델을 만들어낼 수 있습니다. 하지만 Noise와 같이 일반적이지 않은 학습 데이터가 많이 섞여 있을 경우 Overfitting이 발생할 수 있습니다.
Regularization은 학습 데이터를 조금 희생하더라도 모델을 최대한 간단하게 만들어서 Overfitting을 방지하는 기법입니다.
하지만 Regularization은 눈으로 보고 쉽게 확인할 수 있지 않기 때문에 학습 과정에서의 Overfitting 여부를 판단하기가 쉽지 않습니다. 그래서 Overfitting 여부를 손쉽게 판단하기 위해서 ‘검증(Validation)’ 기법을 적용합니다.
검증용 데이터는 학습용 데이터에는 포함시키지 않고, 모델의 성능 검증에만 사용합니다.
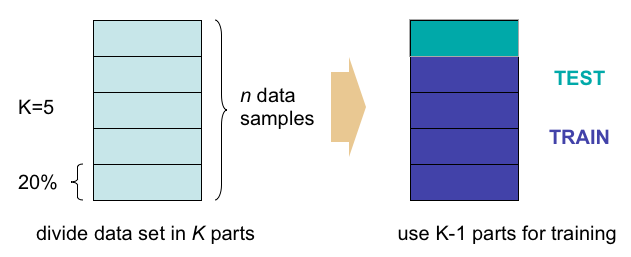
위 그림과 같이 학습 데이터의 일부(보통 80%는 학습용, 20%는 검증용)를 떼어내서 검증용으로 사용합니다.